Tìm kiếm bằng AI kết hợp định vị địa lý (GEO): Hướng dẫn thực tế cho lập trình viên và doanh nghiệp nhỏ

Giới thiệu
Xu hướng kết hợp tìm kiếm bằng AI (semantic search) với dữ liệu định vị địa lý đang ngày càng phổ biến: người dùng tìm kiếm theo ngữ nghĩa nhưng cũng kỳ vọng kết quả phù hợp với vị trí hiện tại. Bài viết này giải thích khái niệm cơ bản và hướng dẫn thực tế cho các lập trình viên, startup hoặc doanh nghiệp nhỏ muốn triển khai chức năng này mà không cần đội ngũ chuyên sâu.
Tại sao kết hợp AI và GEO lại quan trọng?
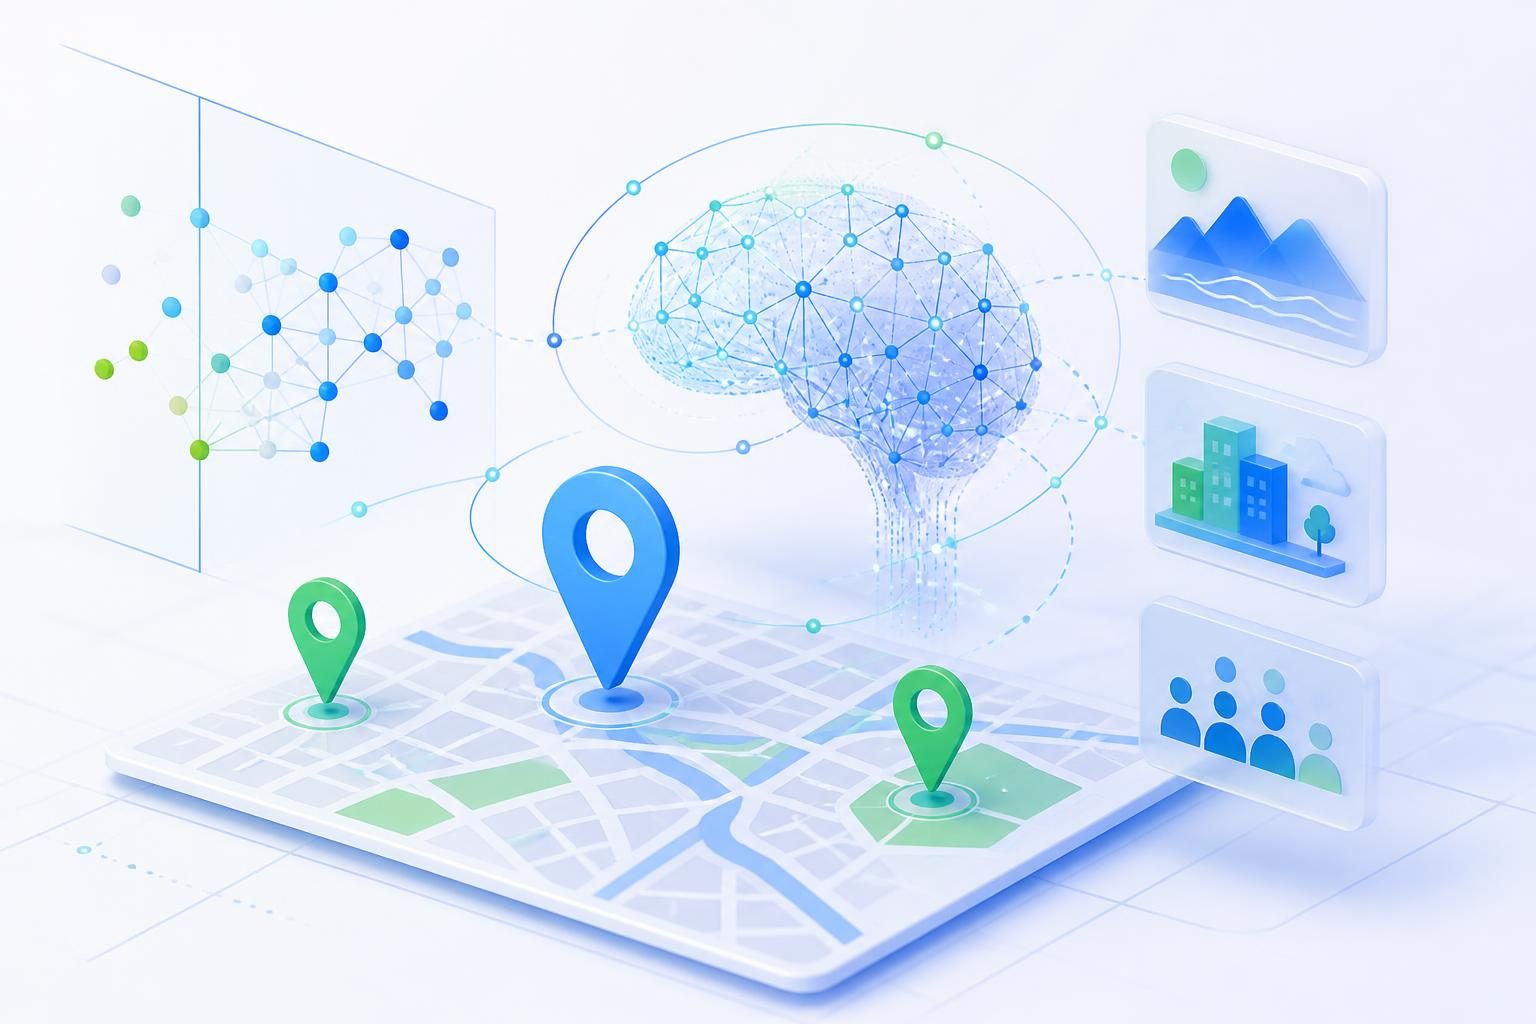
Khi người dùng nhập truy vấn, họ có thể không dùng từ khóa chính xác. Tìm kiếm ngữ nghĩa (dựa trên embedding/vector) giúp hiểu ý nghĩa. Song song đó, vị trí địa lý giúp lọc kết quả thực tế, ví dụ: cửa hàng, dịch vụ hay bài viết liên quan đến khu vực cụ thể. Kết hợp cả hai đem lại kết quả chính xác, phù hợp ngữ cảnh và địa điểm.
Ý tưởng kiến trúc cơ bản
Một kiến trúc phổ biến gồm các thành phần chính:
- Thu thập dữ liệu: nội dung, mô tả, tọa độ (latitude, longitude).
- Tạo embedding: chuyển văn bản thành vector bằng mô hình AI (có thể dùng dịch vụ cloud hoặc mô hình mã nguồn mở).
- Lưu trữ: dùng kết hợp vector database (FAISS, Milvus, Pinecone, hoặc dịch vụ tương tự) và chỉ mục không gian (R-tree hoặc tính toán khoảng cách trực tiếp).
- API truy vấn: nhận truy vấn văn bản + vị trí người dùng → tạo embedding truy vấn → tìm kiếm vector gần nhất → lọc/ưu tiên theo khoảng cách và độ tương đồng.
- Frontend: hiển thị kết quả theo bản đồ, danh sách và cung cấp bộ lọc bán kính.
Cách triển khai bước‑cụ‑thể (dành cho doanh nghiệp nhỏ)
Bạn không cần hệ thống phức tạp để bắt đầu. Dưới đây là các bước thực tế dễ làm:
- Thu thập dữ liệu: Chuẩn hóa nội dung (tên địa điểm, mô tả, địa chỉ, lat/lon). Nếu dữ liệu còn thiếu tọa độ, dùng geocoding để chuyển địa chỉ sang tọa độ.
- Tạo embedding: Dùng API mô hình embedding hoặc mô hình mã nguồn mở để chuyển mô tả từng mục thành vector. Lưu vector kèm ID và dữ liệu vị trí.
- Lưu vào database: Lưu metadata (tên, địa chỉ, url) vào bảng chính và lưu vector vào một vector DB. Đồng thời lưu tọa độ cùng bản ghi để dùng cho lọc GEO.
- Xây dựng API tìm kiếm: Luồng điển hình:
- Nhận truy vấn văn bản và tọa độ người dùng (tùy chọn).
- Tạo embedding truy vấn.
- Tìm N kết quả gần nhất theo embedding trong vector DB.
- Lọc hoặc tính điểm bổ sung theo khoảng cách địa lý.
- Trả về kết quả đã sắp xếp.
- Giao diện người dùng: Hiển thị bản đồ + danh sách, cho phép người dùng chỉnh bán kính tìm kiếm, sắp xếp theo gần nhất hoặc phù hợp nhất.
Thuật toán kết hợp điểm (hybrid scoring)
Một cách đơn giản để ghép điểm semantic và khoảng cách là chuẩn hóa hai giá trị và cộng với tỷ trọng. Ví dụ ở mức ý tưởng:
score = alpha * semantic_similarity + (1 - alpha) * distance_score
Trong đó semantic_similarity là điểm cosine giữa truy vấn và mục, normalized về [0,1]; distance_score có thể tính bằng hàm giảm dần với khoảng cách (ví dụ chọn 1 / (1 + d) hoặc map d thành [0,1] ngược lại). Thay đổi alpha (trong khoảng 0..1) để ưu tiên ngữ nghĩa hoặc vị trí.
Ví dụ luồng tìm kiếm thực tế (mô tả)
- Người dùng tìm “cafe yên tĩnh làm việc” và cho phép chia sẻ vị trí.
- Frontend gửi truy vấn và tọa độ tới API.
- API tạo embedding cho truy vấn, tìm 100 kết quả vector gần nhất.
- Với mỗi kết quả, API tính khoảng cách đến tọa độ người dùng và áp dụng hàm scoring hybrid.
- Sắp xếp theo điểm và trả về 10 kết quả phù hợp nhất, kèm thông tin khoảng cách và giờ mở cửa.
Gợi ý công nghệ cho người mới
- Embedding model: dùng dịch vụ cloud (ví dụ các API embedding) để tránh quản lý hạ tầng mô hình lớn.
- Vector DB: bắt đầu với các giải pháp SaaS (Pinecone, Milvus Cloud) hoặc FAISS nếu muốn self-host.
- Bộ lọc GEO: nếu dùng Postgres, PostGIS có chức năng không gian mạnh; hoặc lưu lat/lon và tính khoảng cách Haversine trong ứng dụng.
- Triển khai: bắt đầu với một API server nhỏ (Node.js, Python Flask/FastAPI) rồi mở rộng khi cần.
Những lưu ý quan trọng
- Quyền riêng tư: Khi thu thập vị trí người dùng, cần xin phép rõ ràng và tuân thủ luật bảo vệ dữ liệu. Không lưu vị trí nếu không cần thiết.
- Chi phí và độ trễ: Tạo embedding cho mỗi truy vấn có thể tốn chi phí và thời gian. Dùng cache cho kết quả phổ biến và cân nhắc giảm tần suất gọi API external.
- Độ tươi dữ liệu: Cập nhật embedding khi nội dung thay đổi. Lên kế hoạch reindex theo lịch cho dữ liệu thường xuyên thay đổi.
- Fuzzy location: Với dữ liệu địa điểm thiếu chính xác, chỉ nên hiển thị khoảng cách ước lượng và cho phép người dùng điều chỉnh vị trí.
- Tránh thiên vị: Khi ghép điểm, cẩn thận để không loại bỏ kết quả có độ tương đồng cao chỉ vì hơi xa; cân nhắc UX hiển thị các tùy chọn “gần nhất” và “liên quan nhất”.
Kiểm thử và đo lường
Trước khi triển khai rộng, test với tập truy vấn thực tế: đo lường tỷ lệ nhấp (CTR), thời gian tìm được kết quả phù hợp (time-to-relevance), và feedback người dùng. A/B testing giữa các giá trị alpha (trọng số semantic vs GEO) giúp tìm mức cân bằng phù hợp với mục tiêu dịch vụ.
Kết luận
Kết hợp tìm kiếm bằng AI và lọc theo vị trí là một cải tiến thiết thực để nâng cao trải nghiệm người dùng, đặc biệt với doanh nghiệp nhỏ có sản phẩm/ dịch vụ địa phương. Bắt đầu từ kiến trúc đơn giản — embedding + vector DB + lọc địa lý — và tối ưu dần theo dữ liệu thực và phản hồi người dùng. Với cách tiếp cận từng bước, bạn có thể triển khai nhanh và mở rộng khi cần.